
Document
Thumbnail
Share
CUID
SWC-60650
TITULO_SERIE
SINOPSIS_SERIE
La Bienal Internacional de Radio, organizada por Radio Educación desde hace 27 años, es un foro académico de relevancia en el ámbito radiofónico de habla hispana. En su décimo quinta edición reúne a especialistas, profesionales y estudiantes de diversos países para reflexionar sobre la radio como medio de comunicación y su papel en la cultura contemporánea, mediante conferencias, mesas de análisis, talleres y el Concurso Internacional de Producciones Radiofónicas.
EXTRACTO_SERIE
La Bienal Internacional de Radio, organizada por Radio Educación, es un foro académico de referencia en el ámbito radiofónico que reúne a especialistas y estudiantes para reflexionar sobre la radio y su papel en la cultura contemporánea.
SINOPSIS_PROGRAMA
Virginia Bazán-Gil analiza la importancia de los archivos y su relación con la Inteligencia Artificial. Se abordan costos, beneficios para investigación y educación, combate a la desinformación y fortalecimiento de identidades, además de dar ejemplos prácticos y económicos. También se discute la monetización de archivos para entrenar modelos de IA y el uso de IA en su creación y catalogación.
EXTRACTO_PROGRAMA
Virginia Bazán-Gil destacó la relevancia de los archivos y su vínculo con la IA, abordando costos, beneficios educativos, combate a la desinformación y su posible monetización, así como el uso de IA en creación y catalogación.
N_PROGRAMA
10
N_TOTAL_PROGRAMAS
18
DURACION_TOTAL
01:04:52:04
PARTICIPANTES
Virginia Bazán-Gil, directora del Archivo de Radiotelevisión Española (RTVE) y miembro de la Cátedra RTVE Universidad de Zaragoza de IA aplicada a Archivos Audiovisuales.
Georgina Sanabria Medina, coordinadora del Programa Ibermemoria Sonora, Fotografía y Audiovisual.
TIPO_ACTIVIDAD
INSTITUCION_PRODUCTORA
PALABRAS_CLAVE
TRANSCRIPCION
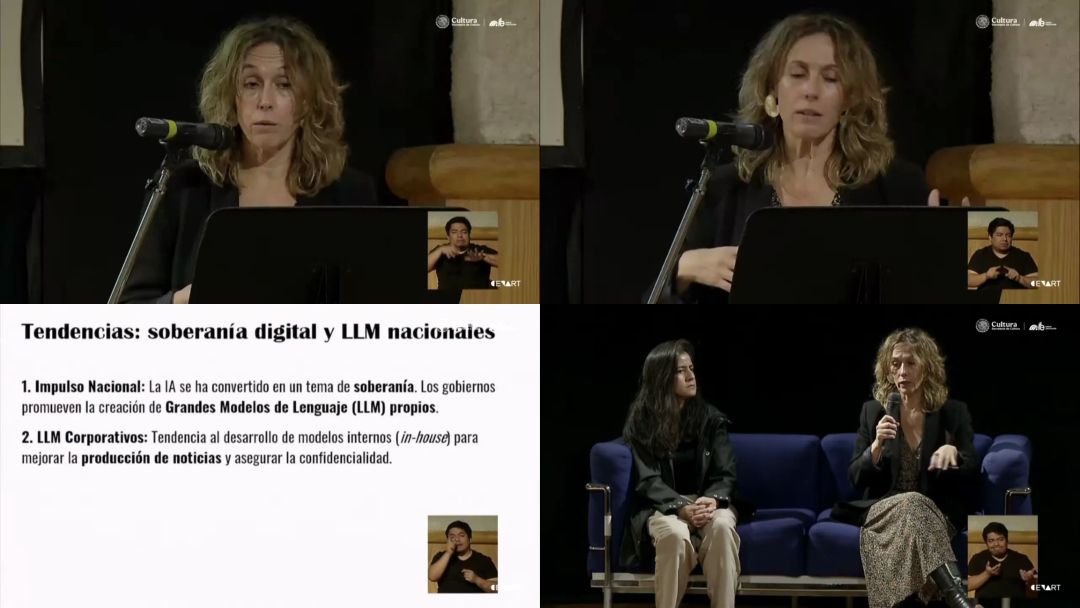
Hola, buenos días, bienvenidas, bienvenidos a este aniversario número 15 de la Bienal Internacional de Radio, cuyo tema es memoria y futuro. Y yo me acordaba, cuando me invitaron a presentar a la doctora Virginia, me acordaba de mis tiempos en radioeducación. Yo empecé haciendo el servicio social en esta institución tan bella y justo hacía esta analogía con la memoria, todo lo que yo empezaba a recordar, la manera en la que se organizaban estos eventos y que siguen siendo vigentes. Y justo hoy vamos a hablar del presente, pero también del futuro, de cuestiones relacionadas con la inteligencia artificial que está pues más vigente que hace 50 años que iniciaron estos esfuerzos de querer automatizar parte de la vida del ser humano. Y entonces decía, qué bonito que me toque a mí estar en este momento en donde puedo hablar del pasado, un poquito haciendo alusión a este evento cuando les decía se organizaba y ahora al futuro. y con una de mis grandes maestras que justo yo el miércoles le decía que de lo que he aprendido yo sobre inteligencia artificial es entre otras personas, es también por ella. Entonces le agradezco muchísimo y me honra mucho que me hayan invitado. Bueno, para presentarla quiero decirles que ella es doctora por la Universidad Carlos III de Madrid, también es presidenta de la FIAT y yo podría decir que es de las personas que tiene un amplio conocimiento y quien ha trabajado muchísimo impulsando políticas, pero también impulsando desde Radio Televisión Española acciones que van en favor del uso de la inteligencia artificial para la preservación de los archivos sonoros y audiovisuales. Entonces yo creo que tenerla ella aquí, que no es la primera vez que está en México, pero tenerla en este espacio es un deleite porque justo viene a compartirnos lo que han hecho ellos, a lo que se han enfrentado y también hacia el futuro. ¿Qué se puede hacer con inteligencia artificial para la cuestión de los archivos medios? Así es que bueno, pues les invito a que prestemos mucha atención y que puedan estar escribiendo sus dudas, sus inquietudes que tengan para poderle hacer al terminar la charla. Muchas gracias, doctora. Bueno, buenos días. Muchas gracias por esta amable presentación. Adelanto que la inteligencia artificial no es sexy y de lo que vamos a hablar durante los próximos minutos será más bien de algo tan importante como el valor de los archivos audiovisuales en esta era de la inteligencia artificial. Antes de comenzar, querría agradecer a la organización de la Bienal que hayan pensado en mí para participar. Para mí es un privilegio estar aquí y escuchar estas presentaciones, estos conversatorios, gente realmente brillante, con unas ideas inspiradoras. Gracias de verdad por haberme permitido venir aquí. Lalo me va a ayudar con la presentación. ¿Cómo podemos hacer así algo mágico, Lalo? Vamos a pasar, si os parece, con él. Exactamente. Esta es un poco la hoja de ruta para esta sesión. Como decía, durante aproximadamente 50 minutos, trataré de dejar un poco de espacio para las dudas, les voy a invitar a reflexionar sobre el valor de los archivos en los medios y lo voy a hacer desde una perspectiva que creo que compartimos, que es la de los medios públicos, porque yo no concibo otra, está en mi ADN. Voy a alternar durante esta presentación dos sombreros. Mi sombrero como presidenta de la Federación Internacional de Archivos de Televisión, Fiatista, y como directora del Archivo de Radio Televisión Española. Voy a comenzar con una clásica definición del archivo. En la declaración, la UNESCO en su Asamblea General de 2011 definía los archivos como un patrimonio único, un patrimonio irreemplazable, que se transmite de generación en generación y que desempeña un papel esencial en el desarrollo de las sociedades, ya que protegen y contribuyen a la memoria individual y colectiva. algo de lo que ayer se habló mucho en esta sala. Pero es que además los archivos de los medios de comunicación somos una parte esencial de esa memoria porque es a través de los medios donde las sociedades nos informamos y reflexionamos a diario sobre nosotras mismas. Gestionar, sin embargo, este patrimonio audiovisual es caro, no vamos a negarlo. Exige una inversión continua en tecnología y en recursos humanos solo para mantener vivos nuestros archivos. Pero no debemos olvidar que los archivos son activos esenciales en esta sociedad actual y nos permiten enfrentar desafíos como la lucha contra la desinformación, la captación de audiencias en un contexto marcado por las múltiples plataformas y canales de distribución y, por qué no, en la Estrategia Nacional de Inteligencia Artificial. Además, en los últimos años, la inteligencia artificial generativa, desde 2022, con el lanzamiento de ChatGPT, ha puesto un foco muy especial en los archivos de medios, como conjuntos de datos para el entrenamiento de algoritmos. Y es algo de lo que vamos a hablar durante esta sesión. Pasamos. Muy bien, estamos sincronizadísimos. Muchas gracias. Bueno, el informe Public Service Media Archives, publicado por la Unión Europea de Radiodifusión en mayo de 2025, identificaba tres elementos esenciales que han impulsado el valor de los archivos en los últimos años. El primero es la pandemia. A pesar de los efectos devastadores de la pandemia, los medios se vieron obligados a buscar recursos internos y a buscarlos de manera rápida. Y en este contexto fue cuando los archivos pusieron de manifiesto que eran un elemento esencial para la producción. Un elemento esencial, un elemento barato y un elemento que devolvía unos índices de audiencias muy interesantes. El segundo elemento es la transformación del mercado. El auge de los modelos FAS y ABOD, servicios gratuitos que se basan en publicidad, ha disparado la demanda de contenido de archivo. Requieren de mucho contenido de manera rápida y también de manera, digamos, económica. Y por último, el auge de la inteligencia artificial generativa, que pone, como decía antes, el foco en los archivos como una fuente de datos de alta calidad para el entrenamiento de modelos. Pero si hablamos del valor de los archivos audiovisuales, tenemos que preguntarnos cómo medimos lo invaluable. ¿Cuál es el retorno de la inversión de un archivo que es, por su naturaleza, patrimonio audiovisual? Perdón, patrimonio inmaterial. Bueno, esta es una pregunta que a menudo se hacen los gestores de nuestros medios de comunicación. Y ayer se hablaba mucho de nunca hay presupuesto. No hay presupuesto para la producción, mucho menos para los archivos. Bueno, pues si tenemos que medir, si tenemos que hablar de valor y tenemos que medir los archivos, el primer dilema es ¿qué métrica aplicamos? ¿Hablamos de horas? ¿Hablamos de activos? ¿Hablamos de tamaño digital? nuestros archivos, los radiofónicos y los de las televisoras son heterogéneos. ¿Cómo sumamos horas de audio y horas de vídeo? ¿Cómo comparamos entre un archivo de palabra en un archivo sonoro y un archivo de música? Y el volumen es increíble. Yo no soy capaz de imaginar estas cifras. Solo los medios públicos de la zona EU, la Unión Europea de Radiodifusión, emitieron 23,4 millones de horas de radio y 17,3 millones de horas de televisión lineal. No estamos hablando de contenidos digitales. Las dimensiones son increíbles. Esto en la última década. Decidir cómo valoramos los archivos es algo para lo que necesitamos tomar una posición. ¿Y qué tres enfoques podemos adoptar? Podemos adoptar el más conservador, que es el valor por el coste de mantenimiento. Y para ello lo que hacemos es considerar el coste de la digitalización. Es muy caro digitalizar, esto lo oímos muy a menudo en nuestras organizaciones. y de la preservación digital a largo plazo, todavía más caro. Pero también podemos considerar cuál es el coste de la no preservación, es decir, la pérdida de patrimonio, pero además la pérdida de ingresos. Si nuestros archivos no están digitalizados, perdemos oportunidades de monetizarlos. Es un enfoque esencial, pero muy limitado. La segunda posibilidad es el valor de mercado, la monetización, y aquí podemos hablar o tomar dos enfoques. Por una parte, la reutilización interna, lo que nos ahorramos si utilizamos material de archivo. Y es un valor que generamos dentro de nuestras propias organizaciones, bien en forma de producciones propias, bien en forma de coproducciones con terceros. Podemos hablar también de monetización externa, es decir, hablamos de ingresos directos por la venta de secuencias o sonidos, por la venta de programas completos, aunque afecte solo a una parte pequeña de nuestro catálogo. y la vía más reciente y todavía por explorar que es la venta de nuestros datos. Este sería el enfoque que tiene que ver con la monetización y tenemos un tercero que es el enfoque estratégico, el holístico, que considera el archivo en el contexto de la industria de los medios de comunicación y el entretenimiento. En este sentido, según PricewaterhouseCoopers, una de las firmas de servicios profesionales más grandes del mundo, y voy a leerlo, la industria de entretenimiento y medios de comunicación seguirá creciendo hasta alcanzar una facturación global de 3,4 billones de dólares en 2028. El ecosistema es más dinámico que nunca y ofrece oportunidades en el ámbito de la publicidad, el streaming y los mercados emergentes. Y aquí acaba la cita y esta es mi aportación. En este contexto, el archivo es un elemento clave para este crecimiento. Bueno, una vez que hemos establecido un poco este contexto, cómo podemos medir el valor, vamos a empezar a hablar de algo que creo que compartimos todos, que es esta visión del valor social del archivo. El valor como memoria, el archivo como verdad, como democracia y como resistencia, enlazando un poco con algunos de los conversatorios que escuchamos ayer aquí. Cuatro pilares fundamentales que podemos señalar en esta línea del valor social del archivo. Por una parte, el archivo como el antídoto contra la desinformación. El archivo es testimonio de lo que ocurrió y de lo que se dijo. Es cierto que tiene un sesgo porque los archivos representan la historia de quienes lo produjeron a lo largo de los años y por tanto tienen puntos de vista sesgados. Pero si lo contextualizamos correctamente, el archivo nos ayuda a mitigar la aceleración de la desinformación. El archivo, por supuesto, es base para la investigación. Ayer contábamos en la sala con investigadoras que trabajan utilizando los archivos. Es un vasto registro visual y sonoro para el análisis académico. Desde luego, los archivos, igual que la radio, tienen un papel fundamental en la enseñanza y el aprendizaje. Es un material contextualizado que permite a las nuevas generaciones conocer su cultura, pero también conocer otras culturas. Y por último, los archivos son elementos esenciales para fortalecer la identidad. nuestra identidad como sociedades, pero también nuestra propia identidad individual. Y en ese sentido hay proyectos muy bonitos como el de la BBC que trabaja con pacientes con demencia y los conecta con sus recuerdos a través del archivo. Este es el valor social, probablemente el más conocido, el que más nos gusta, con el que más disfrutamos, pero tenemos que hablar de un valor económico. Y aquí es donde todavía tenemos mucho trabajo por realizar. Hemos dado unas pinceladas antes, pero podemos hablar, cuando hablamos de valor económico, de reutilización creativa interna. La reutilización diaria de nuestros archivos de radio y de televisión es probablemente el uso más habitual, pero también el que pasa más desapercibido. En Fiatista tratamos de abrir un diálogo claro y directo sobre el valor financiero de los archivos. En este sentido, el pasado 7 de octubre celebramos un webinar en el que intercambiábamos distintos puntos de vista sobre este tema. Y aquí, bueno, esta grabación estará disponible en abierto probablemente después de la conferencia de Fiatista en octubre y podrán echarle un vistazo si les interesa. ¿Cómo podemos garantizar la reutilización creativa de nuestros archivos? Dando acceso directo a los sistemas de gestión de archivo, a los MAM, a los creadores. Por ponerle una cifra a la posibilidad de reutilizar el archivo, en el caso de RTVE reutilizamos mensualmente 3.000 horas de archivo de televisión y 1.000 horas de archivo sonoro. Es decir, es una cantidad interesante. Y luego hay múltiples aplicaciones creativas y he traído algunos ejemplos. Vamos a comenzar con el primero. El primer vídeo corresponde a la celebración del centenario de la radio en España. vamos más retrasados que aquí en México, sus radios son mucho más ancianas y esto es un uso muy creativo del archivo sonoro. Lalo, por favor. Ahora arranca el audio. es un escape room digital que recorre la historia de la radio por décadas el usuario es invitado a elegir una década y a resolver las pistas que le permitirán salir de este escape room digital a través de distintos sonidos de la radio en España no se oye el audio Bueno, este escape room digital está disponible en abierto, buscándolo en cualquier buscador, 100 años de radio, Radio Televisión Española y las pruebas se oía bien. Si podemos avanzar tal vez hasta la parte de que sí que tiene audio. Aquí lo escuchábamos antes, de hecho escuchábamos una cancioncilla antes. Por sí mismo. en ese escape room digital es el sonido más antiguo que conservamos en el archivo sonoro, que es unas señales horarias y un mensaje en clave que dice Madrid, pulgarcito, te manda un beso. Radio Nacional de España nació como un elemento propagandístico del bando sublevado en el año 38 y lo utilizaba de esa manera, como un elemento propagandístico. Bueno, es una pena que no podamos oírlo pero vamos a intentar pasar al siguiente ejemplo que es en este caso, bueno este ejemplo corresponde a otra iniciativa del RTVE Lab que trataba de representar con material de archivo cómo el machismo marcó a distintas generaciones de mujeres en España. Y es un uso creativo del material de archivo que nos valió un reconocimiento, un premio fiatista al uso más innovador del archivo. Entonces el usuario selecciona la década en la que nació y, no sé, tenemos problemas con el audio, qué lástima. Y bueno, pues se muestra que para una persona nacida en la década de los 70, cuando tenía 13 años, la película más relevante fue Pretty Woman, una película que blanqueaba todo el tema de la prostitución. O cómo Guns N' Roses sacó un disco espectacular en el que también se hablaba de las mujeres o cómo nuestro cuerpo tenía que responder a unos cánones de belleza que son absolutamente imposibles de alcanzar. Y vamos a ver si tenemos suerte con el tercer ejemplo que he traído hoy. Es una reutilización tal vez más habitual, que es el uso de confrontar a los protagonistas con audios del pasado. Vamos por favor al siguiente vídeo. Bueno, esto es un audio, a ver si tenemos suerte aquí. ¿Tobar la infancia o la adolescencia debería ser una...? Sí, sí, sí. Bueno, esto es un podcast, Radiogramas, dirigido por Javier Hernández, que es una persona maravillosa. Y en este caso tiene que ver con los reformatorios de mujeres durante el franquismo en España. Muchas adolescentes eran enviadas por sus padres a estos reformatorios. Y en este caso concreto se encuentra el testimonio de Alfonso Paso, un importante dramaturgo español, que si pudiéramos oír el audio sería maravilloso, hablaba del amor que sentía por sus hijas, una de ellas fue enviada a un reformatorio femenino. Se escuchaba perfectamente. Bueno, pues si no podemos oírlo de nuevo, lo lamento. Aquí estamos. De monjas que deberían cuidar de niñas y adolescentes, pero a cambio las insultan y ejercen la violencia contra ellas con el permiso, el ruego y el beneplácito de sus padres para evitar que se pierdan pensando por sí mismas. El dramaturgo Alfonso Paso defiende en la radio de 1965 al que llama el Clan Paso. Cuando alguien ataca, esto que pudiéramos llamar, utilizando la palabra, por decirlo, la acepción escocesa, alguien ataca al plan paso, todos nos volvemos amigos de todo y cerramos los codos y sabemos defendernos. Usted es casado, ¿verdad? ¿Cuántos hijos tiene? ¿Cómo se llaman? Vamos a continuar. Este es simplemente un ejemplo de cómo utilizar de nuevo el archivo para confrontar el pasado con sus protagonistas. Y si seguimos hablando de valor económico, tenemos que hablar de estos canales FASTA, los que antes hacíamos referencias, como una nueva oportunidad. El mercado es mucho más fluido, requerimos de un suministro constante de material. Cada vez hay una demanda mayor de documental, generalmente histórico, que son los productos que más utilizan el material de archivo. Y luego hablábamos de la venta de licencias a terceros. ¿Podemos poner la presentación, por favor, en modo presentación sin que se vean las notas? Entonces, en este gráfico que teníamos aquí, estos son datos que corresponden a la memoria de servicio público de RTVE, y en concreto son los ingresos generados por la comercialización de contenidos en 2024. Esta comercialización incluye la venta de programas completos, incluye la venta de secuencias de archivo. Para que se hagan una idea en determinados medios europeos, 5 minutos de archivo se cotizan entre 5.000 y 8.000 euros, dependiendo de los derechos que se negocien, que pueden ser desde un territorio determinado, multiplataforma o cine. Pero el valor de los archivos es alto cuando se monetiza. Bueno, vamos a continuar, creo que ya hemos sentado un poco las bases de esta transición de los archivos como centros de coste a los archivos como centros de valor. Vamos a reivindicar nuestro valor dentro de nuestras organizaciones. En este sentido, la inteligencia artificial puede ser una aliada para manejar el volumen y la complejidad de los archivos modernos, desde la preservación hasta el acceso. Desde Fiatifta hemos impulsado varias iniciativas para comprender cuál es el uso actual que los archivos de los medios hacen de la inteligencia artificial. Estas iniciativas junto con el Public Service Media Archives, al que antes hacía referencia, publicado por EBU y que lamentablemente solo está disponible para miembros de EBU, son las principales herramientas para comprender el estado actual de la inteligencia artificial en los archivos media. Si analizamos todo el flujo de trabajo de los archivos, desde la fase de adquisición de los contenidos hasta la fase de acceso, podemos identificar herramientas que nos permiten trabajar de manera más ágil, de manera más rápida para hacer nuestros archivos más accesibles. En la adquisición podemos hablar de supervisión del estado de las grabaciones, detección de duplicados para la gestión de los archivos digitales. En el área de preservación podemos hablar de planes de preservación digital asistidos por inteligencia artificial, controles de calidad, restauración, con todas las implicaciones y debates que tiene esta restauración, pero hay herramientas que nos pueden ayudar a hacer contenido más adecuado para los gustos de las audiencias si esto es lo que queremos hacer, que ya son cuestiones editoriales. En la parte de documentación es probablemente donde hay un mayor desarrollo de las herramientas de inteligencia artificial. Y por último en el acceso desde la gestión de derechos para la detección de usos no lícitos hasta la verificación de permisos de acceso o la accesibilidad para la generación automática de traducciones, de subtitulado o incluso videosignado. pero he de decir que un avatar jamás va a alcanzar la expresividad de la persona que tenemos aquí, que es una maravilla ver cómo trabaja. Acaba cansado, es cierto, pero es maravillosa la expresividad de su interpretación en lengua de signos. Bueno, pues desde la más absoluta humildad quería compartir lo que yo creo que es un caso de éxito, como es el uso de la inteligencia artificial en el archivo de RTVE. Nosotros hemos apostado por una estrategia en inteligencia artificial que pretende mejorar los procesos, simplemente esto. ¿Y cómo lo hacemos? A través de servicios de metadatado automático que hemos adjudicado a proveedores externos mediante un concurso público. Los pliegos están disponibles en la web de RTVE, dedicada a las licitaciones, y son documentos que yo creo que tienen relevancia, porque por un lado muestran la evolución de la tecnología desde el año 2020, que licitamos el primer pliego, hasta la actualidad. El último pliego que hemos adjudicado, el último servicio que hemos adjudicado ha sido este mismo mes, bueno este mismo mes ha entrado en producción en 2025 y como digo todos los requisitos técnicos, la tecnología que requerimos están contemplados en esos documentos. En el caso del archivo de radio hemos comenzado de manera más tardía en este mismo año, a principios de año. Todo esto lo hemos llevado a cabo con una política absolutamente transparente con nuestros equipos, con nuestros profesionales, con las archivistas y hemos contado qué estamos haciendo, no engañamos a nadie. Y ha sido un proceso de aprendizaje y sigue siendo un proceso de aprendizaje constante porque necesitamos por un lado que la inteligencia artificial se integre en nuestra cultura organizativa y no al revés. Necesitamos que la inteligencia artificial se integre en nuestra infraestructura tecnológica y necesitamos que la inteligencia artificial se integre en nuestros procesos y no al contrario. Por tanto, tenemos un control desde el principio de los algoritmos con los que trabajamos. Por tanto, decía que la inteligencia artificial no tiene nada de sexy porque nosotros lo contemplamos desde el punto de vista de un paso más en la automatización para obtener metadatos fiables que nos permitan acceder a nuestros recursos. Vamos a intentar ver el siguiente vídeo que corresponde a... Franja de Gaza. Un primer paso que ha compartido con Hamas, al que ha instado a aceptar las condiciones para que se produzca el alto al fuego inmediato y la liberación de rehenes y prisioneros que marca su plan de paz. Ahora, según el líder estadounidense, la pelota está en el tejado del grupo islamista, al que exige una respuesta sin demoras. Y en Ucrania, al menos una persona ha muerto en la provincia de Saporilla, en el sureste, tras los ataques rusos de esta madrugada. Esto que estamos viendo aquí es el acceso a nuestra herramienta de inteligencia artificial para el archivo sonoro. Estamos analizando 160 horas de Radio 1 y Radio 5 Todo Noticias y además tenemos un porcentaje de horas para trabajar con material histórico, con material de hace años que no teníamos descrito. ¿Qué obtenemos? Transcripción del audio a texto, segmentación por hablantes, lo veíamos en el panel central con identificación de género, si habla un hombre, si habla una mujer, palabras clave que aparecen a la derecha, segmentación de noticias en el caso de los noticiarios, automáticamente resumen automático del contenido y clasificación por categorías. Este proyecto ha requerido de un alto grado de personalización, sobre todo en la detección de entidades y en la generación de resúmenes y ha requerido, como todos nuestros proyectos, de la implicación de profesionales de distintas áreas, no solo del archivo, también ingenieros, expertos en inteligencia artificial y por supuesto las empresas proveedoras de servicio. El siguiente ejemplo corresponde al servicio de metadatado automático de televisión, que lo que hace es aplicar una capa o incluir la parte de análisis de la imagen. Hola, ¿qué tal están? Muy buenas noches. Dirisa y Formentera se han llevado la peor parte del temporal que dejó el ex huracán Gabriel. La UME acaba de llegar a las islas donde muchas personas se han visto atrapadas por el agua en sus coches o en sus casas. hay dos heridos por caídas en la calle. Después de varias horas, sin luz, ha vuelto de forma generaricada. La disposición es la misma. Aquí lo que tenemos son los fotogramas clave. A la izquierda un resumen que se genera automáticamente. En la pantalla central una transcripción con segmentación por hablantes. y a la derecha lo mismo, tenemos palabras clave, tenemos protagonistas, el vídeo está segmentado también por las principales temáticas y tenemos una parte de descripción automática de la imagen, un trabajo que habitualmente realizaban los y las documentalistas. Esto es lo que tenemos aquí a la derecha. Lógicamente todos estos metadatos están referenciados a un código de tiempo, lo que nos permite ir a ese punto exacto en el vídeo o en el audio, de tal forma que si queremos recuperar un total, una declaración concreta, podemos recuperarlo de forma muchísimo más ágil. Bueno, hemos visto, por tanto, qué puede hacer la inteligencia artificial por los archivos y ahora nos toca responder a la siguiente pregunta. ¿Qué pueden hacer los archivos por la inteligencia artificial? En junio de 2024 Fiat Ifta publicaba una llamada a la atención de su entonces presidente, Brecht de Klerk, en la que se destacaba el valor estratégico de los archivos de medios y se equiparaban sus datos al nuevo petróleo digital. Este documento está disponible en inglés y de manera abierta en la página de Fiat Ifta y es, creo en mi opinión, un documento de referencia en este momento. Pero ¿por qué somos importantes los archivos para la inteligencia artificial? Vamos a intentar responder a esta pregunta. Los algoritmos devoran datos a un ritmo insostenible. Se estima que los grandes modelos de lenguaje consumirán todos los datos públicos disponibles entre 2026 y 2032. En otras palabras, los datasets públicos, las páginas web, no serán suficientes, lo que obligará a la búsqueda de fuentes alternativas de datos. Son como los pozos de petróleo, una vez que se agota uno hay que seguir buscando el siguiente. En este sentido, la industria del cine y televisión y por supuesto sus archivos son un objetivo para las grandes tecnológicas. Y nuestros archivos, los archivos de los medios de comunicación públicos, tienen una calidad que es difícilmente comparable a otras fuentes de datos. ¿Qué es lo que hace que los archivos de los medios públicos sean tan únicos? Por una parte, su volumen. Para que se puedan hacer una idea, una hora de archivo de radio digital equivale a 10 millones de páginas de un periódico. Después, por su calidad profesional. El contenido es de producción profesional. La captación de la imagen, cómo se prepara el audio, los guiones en la radio, el habla natural, espontánea. Además, aplicamos estándares y metadatos, lo que hace que estos sonidos y estas imágenes que preservan nuestros archivos estén acompañadas de metadatos detallados y verificados por humanos, lo que maximiza su valor para el entrenamiento de modelos. Y por último la amplitud y cobertura. Por su programación concentran una diversidad sin igual de géneros, de temas y de perspectivas sobre la realidad de un país. Este es el motivo por el que nuestros archivos son tan importantes para las nuevas, para las grandes tecnológicas. Pero hablemos del mercado de los datos. Este mercado de los datos se mueve entre la zona gris legal y los grandes acuerdos millonarios. El uso de material con derechos de autor para entrenar a la inteligencia artificial, como decía, se encuentra en un área legal ambigua que los legisladores están empezando a abordar. Desde mediados de 2023, investigaciones y demandas judiciales como la de New York Times han demostrado que las empresas de inteligencia artificial han estado utilizando contenido protegido por derechos de autor y copyright para entrenar sus modelos, utilizando una técnica llamada scrapping. Es una técnica de extracción de datos que utiliza un software que se conecta a una página web y automáticamente extrae toda la información que aparece aquí. Aquí vemos algunos titulares, Disney y Universal se unen en una demanda, el primero en llegar fue The New York Times y Getty Imágenes acaba de demandar a Estability AI por violar derechos de autor. Si utilizan algún agente de inteligencia artificial y se han preguntado en algún momento por qué nunca es posible borrar el historial, es como consecuencia de esta demanda de The New York Times. Bueno, pues frente al scrapping, compañías de inteligencia artificial han negociado acuerdos de licencia con varios medios de comunicación y proveedores de imágenes. Aquí tenemos algunos ejemplos. OpenAI firmó en 2023 un acuerdo con Associated Press, en 2024 con News Corp, propietarios, entre otros, del Wall Street Journal, un acuerdo que se llegó a cifrar en 230 millones de euros. Ahí es nada. Y recientemente han firmado Prisa Media y el diario Le Monde. El negocio parece ser tan apetecible que ya han aparecido las primeras empresas que licencian material de archivo para el entrenamiento de algoritmos, convirtiéndose en una fuente de recursos para aquellos que quieran acogerse a este modelo. Pero más allá de las negociaciones entre medios y empresas tecnológicas, ¿cuáles son las tendencias actuales en materia de inteligencia artificial? Tenemos dos líneas, el impulso nacional, la inteligencia artificial se convierte en un tema de soberanía para los gobiernos, los gobiernos promueven la creación de grandes modelos de lenguaje propios, ¿por qué? Porque hay una preocupación clara de dependencia tecnológica de China o de Estados Unidos. En este sentido, el Reino Unido ha recomendado la creación de un dataset nacional con contenido de la BBC y de los archivos nacionales. En Francia, el INA, el Instituto Nacional del Audiovisual, se ha convertido en una pieza esencial en la estrategia de inteligencia artificial del gobierno francés. Y en España, en febrero de 2025, el gobierno anunciaba una infraestructura pública de inteligencia artificial en castellano y lenguas cooficiales. Esta es la tendencia soberanista en el uso de la inteligencia artificial y el papel que los archivos de los medios de comunicación públicos pueden jugar. Y por otra parte tenemos una línea de grandes modelos de lenguaje corporativos. Es una tendencia al desarrollo de modelos internos del que es un exponente la BBC. Son proyectos que se desarrollan in-house dentro de las organizaciones para la producción de noticias, asistentes a la producción de noticias y para asegurar la confidencialidad de los datos de las propias organizaciones. Bueno, entonces parece que estamos en una encrucijada. ¿Qué hacemos? ¿Apostamos por el servicio público o monetizamos nuestros archivos? ¿Son caminos incompatibles? ¿Tenemos que ir a la izquierda? ¿Tenemos que ir hacia la derecha? Creo que hemos visto que el archivo es un activo de alto valor que además promete grandes retornos en esta era de la inteligencia artificial. Sin embargo, antes de avanzar y comprometernos y firmar este cheque millonario que nos pueden ofrecer, hay que pararse a pensar cómo este tipo de acuerdos pueden comprometer nuestra misión fundamental de servicio público. El archivo es esencial, como hemos ya establecido, para este servicio público, para la memoria, para la democracia. El dilema es cómo gestionamos este activo, este valor sin traicionar esta vocación de servicio público. Y por tanto necesitamos una evaluación exhaustiva que vaya más allá de la valoración económica. Debemos considerar todas las implicaciones, desde las legales hasta las reputacionales. Y por tanto, nos enfrentamos a cuatro retos críticos en la cesión de nuestros datos a las grandes corporaciones. Por una parte, esta es una decisión estratégica, debemos decidir si cedemos nuestros datos o no. Y si lo decidimos o si queremos emprender ese camino, debemos pensar si esto apoya nuestros objetivos a largo plazo. debemos evaluar cuidadosamente el riesgo reputacional que puede tener aliarse con algunas organizaciones, empresas, más bien, de dudosa reputación. O incluso los propios acuerdos, si no son suficientemente claros, si no están bien atados, pueden acabar dañando nuestra propia reputación. Debemos considerar también las cuestiones legales. Hablábamos de una zona gris legal. El entrenamiento de algoritmos con material de archivo infringe la ley. No poseemos en los medios de comunicación el 100% de los derechos, recordemos, los derechos de autores, de los guionistas, de los músicos, de los actores, de las actrices. No poseemos el 100% de esos derechos. Y luego la protección de datos. Debemos considerar las limitaciones. En el caso europeo, la ley de inteligencia artificial es muy estricta y clasifica los sistemas de reconocimiento facial como el que hemos visto en el ejemplo del servicio de televisión como un sistema de alto riesgo. De tal manera que los medios tenemos que ser capaces de demostrar que lo que estamos haciendo responde a la legalidad. Seguimos avanzando en los retos, el reto económico. Vivimos en ecosistemas que están diseñados para asegurar la emisión de radio y televisión. Son sistemas aislados, protegidos, porque hay que garantizar que la televisión no se va a negro y hay que garantizar que la radio sigue emitiendo. Y por tanto, no debemos considerar como baladí el sacar todos esos datos de ese ecosistema para entrenar modelos. Tiene unos costes económicos que también debemos valorar. ¿Quién va a hacerse cargo de esos costes económicos? ¿Los medios de comunicación o las tecnológicas? Y por último, es ético. Debemos considerar la ética que está implicada en todo esto. Es probablemente este cuarto reto el más importante para los medios públicos. Cualquier acuerdo al que lleguemos debe asegurar un uso ético de nuestros datos, que nuestros datos no se utilizan para entrenar modelos que propaguen la desinformación o que amplifiquen los sesgos o que amplíen la brecha digital. Y si cedemos nuestros datos debemos exigir que esto es así como medios públicos. Así que estoy llegando al final para abrir un turno de debate. Hemos llegado a la conclusión de que los archivos de los medios somos la base de las sociedades democráticas, que debemos apostar por aquellos aspectos que nos unen como sociedad, aquellos aspectos que compartimos. Somos un activo estratégico capaces de generar ingresos económicos para nuestras organizaciones. Somos importantes, debemos empezar a hablar desde la perspectiva de quien importa, de quien contribuye, de quien tiene un valor para la organización. No somos cuartos oscuros donde se almacenan cintas, no. Somos capaces, insisto, de atraer dinero, de generar valor, de producir nuevas narrativas, de fomentar la industria audiovisual. Somos importantes y cada mañana tenemos que levantarnos y decirnos esto, porque si no, sin presupuestos y también sin ganas es muy difícil trabajar. Así que nuestra responsabilidad como archivistas es liderar un uso ético y soberano de este activo para que la inteligencia artificial sirva para las sociedades y no al revés. Así que estoy encantada de responder a sus preguntas, sus comentarios y de que hablamos un pequeño debate. Muchas gracias. Bueno, empiezo con una pregunta y así animo a que los demás también puedan hacer sus preguntas o incluso a lo mejor reflexiones a partir de lo que la doctora nos compartió. Además de saber que… le voy a dar el micrófono, ¿verdad? Porque si no, ¿cómo nos va a contestar? Ah, ¿tiene ahí? Bueno, además de darse cuenta que la inteligencia artificial no es sexy, ¿Qué aprendizaje le ha hecho volar la cabeza relacionado con el uso de inteligencia artificial para los archivos de medios públicos? A lo largo de todo este tiempo que ha ido ya trabajando con ello. Bueno, aquí he puesto un poco el foco, me voy a quedar de pie contigo. Bueno, nos sentamos, nos sentamos. Aquí he puesto un poco el foco en los proyectos de generación de metadatos de forma automática, es decir, generamos algo que es tradicional en los archivos, que son metadatos que nos permiten hacer una recuperación por palabras. Pero ya desde hace un año, junto con la Universidad de Zaragoza, la Cátedra de Radiotelevisión Española con la Universidad de Zaragoza, estamos trabajando en algo que es mucho más increíble, que es la representación basada en espacios semánticos vectoriales. Esto, que suena muy complejo, es todavía más difícil de explicar, pero básicamente consiste en que eliminamos toda la parte de generación de metadatos automáticos, que lo que hacemos es, digamos, confrontar nuestro archivo con modelos entrenados en los que en un espacio vectorial, que es como una especie de mapa, las imágenes y los metadatos se han superpuesto. Cuando estos algoritmos entrenados de esta manera, con contenidos que no son los nuestros, son aplicados sobre nuestras colecciones, podemos explorarlas sin utilizar palabras clave. Podemos interrogar el lenguaje natural a estos algoritmos y podemos hacer búsquedas con imágenes. Esto es maravilloso en el contexto de los medios, sobre todo en televisión, cuando un informador quiere una imagen muy concreta que solo está en su cabeza. Así que yo creo que este es el futuro y por lo menos en esa línea estamos trabajando. Muchas gracias. ¿Alguien tiene alguna pregunta? Hola Virginia, muchas gracias por todo lo que nos comentas. Yo creo que es una opinión personal. En México vamos varios pasitos atrás de todo esto que nos comentas en los medios en general y en los medios públicos. Pero quisiera saber tu opinión al respecto del encuadre legal y político que se tiene que tener previo para poder adelantar una estrategia así en los medios públicos. Tú has hablado que hay la ley de inteligencia artificial en Europa y también una estrategia de inteligencia artificial a nivel España, gobierno español, ¿qué tan necesarios son y más bien cómo se pueden alinear, primero o se deben alinear esto en la materia político-legal para bajarlo a una estrategia en medios públicos? Bueno, yo debo decir en primer lugar que nosotros tenemos la suerte, hemos tenido la suerte de empezar a trabajar en inteligencia artificial porque teníamos una dirección de innovación y estrategia tecnológica fuerte. A menudo iniciar este camino depende de personas visionarias y da igual, probablemente estas personas visionarias viven en México, viven en España o pueden vivir en cualquier otro país, con lo cual este es un paso importante. Nosotros empezamos a trabajar de manera muy temprana en 2017 gracias a esta línea de liderazgo de la dirección estratégica. En ese momento solo se empezaba a hablar del uso de la inteligencia artificial en medios de comunicación desde la perspectiva editorial. De nuevo, la creación de contenidos, digamos que acapara todo el debate. Se habla de si la inteligencia artificial es válida para generar noticias o no, si es ético. Y todos los códigos deontológicos del uso de la inteligencia artificial en los medios de comunicación trabajan en esa línea. ni siquiera son capaces de prever que los contenidos que se generen a través de estas tecnologías en el futuro formarán parte del archivo. Como siempre, la producción está primero y el archivo es esa habitación en la que vamos amontonando cosas. Entonces, aquí creo que va a haber un trabajo interesante sobre este tema. Por lo tanto, aterrizando un poco la pregunta, nosotros empezamos a trabajar cuando no había una política nacional, empezamos a trabajar cuando no había unas directrices dentro de los medios de comunicación y cuando decía que la inteligencia artificial no es sexy es porque nosotros hemos tratado siempre de apartarnos del debate sobre todas estas consideraciones éticas y asumir la inteligencia artificial como una herramienta que nos permite dar acceso, mejorar nuestros procesos. Aquí hay una cuestión importante que señalaba, que es cómo podemos formar nosotros los archivos parte de esa estrategia nacional. Pero yo creo que es que esas estrategias nacionales todavía siguen sin mirarnos a los archivos, todavía no son conscientes. Por tanto, lo que quiero decir, para resumir un poco esta respuesta tan larga, es que a menudo la legislación va por un lado y la práctica por otro. y en algún momento se encuentran y cuando se encuentran el resultado no suele ser bueno, porque nosotros antes hacíamos reconocimiento facial y ahora ya no vamos a poder hacerlo, por ejemplo. No sé si he respondido a la pregunta. Gracias, qué amable. Virginia, a mí me preocupa mucho el asunto del almacenamiento, de que no hay almacenamiento que sea suficiente, de que la obsolescencia nos lleva a que después de preservarlo en un formato, hay que pasar a la preservación de otro. Hay algunas directrices en Radio y Televisión Española o que tú conozcas como para jerarquizar qué hay que preservar y qué no, qué hay que catalogar y qué no, porque de repente parece como que si todo lo que produces, todo el tiempo, 24-7, todo tiene que entrar a la fonoteca, todo hay que catalogar, todo hay que guardar y todo hay que estar transfiriendo, es que se vuelve una cantidad de gente que después te hace, desde mi perspectiva, que pierdes visión sobre lo que a lo mejor es importantísimo y estratégico guardar. y muchas cosas que como en todo archivo, por ejemplo el de papel, en el archivo de papel descartamos y de repente nuestras fonotecas pues creo que no nos queda tan claro cómo hacer esa jerarquización. Sí, este es un gran problema, la verdad, el de la preservación digital a largo plazo, el de los formatos. En el caso de Radio Televisión Española y de muchos medios europeos, es obligatorio tener una copia legal que está disponible durante seis meses. Y luego nosotros no guardamos todo lo que producimos, esto es así. No tenemos capacidad, tenemos siete emisoras de radio que emiten 24 horas al día, siete días a la semana. Tenemos seis canales de televisión, Tenemos medios digitales, estamos perdiendo contenido que se produce digitalmente y solo para los medios digitales y esto es un problema porque es una pérdida de patrimonio. Yo creo, y a lo mejor me tachan de hereje, no lo sé, que no podemos aspirar a preservarlo todo. No podemos y ¿qué tenemos que aplicar? Sentido común. Yo a menudo me pregunto si de verdad tiene sentido que estemos preservando todos los días el programa de la Lotería Nacional. No lo sé, pero a veces es mejor no hacerse estas preguntas existenciales. Y bueno, nosotros en cuanto a los formatos preservamos en calidad broadcast. Aquí debo decir que tengo el privilegio de trabajar en una empresa que sí apuesta por la preservación digital de su archivo porque lo monetiza. y que de manera sistemática tenemos un almacenamiento, una librería robotizada, todo nuestro archivo es un archivo esencialmente digital, aunque todavía tenemos material en formato cine que no hemos sido capaces de digitalizar, porque primero con la digitalización de la producción nos enfocamos a los formatos más recientes, los Umatic, la pulgada, las dos pulgadas, los betacanes, Y ahora que ya esta parte la hemos superado, estamos mirando los primeros años de la televisión, a los años 50, que es un material que tiene un valor histórico incalculable. Y entonces aquí también nos surgen dudas. ¿Guardamos todas las copias de positivo de los rollos de cine? Pues igual no. O igual no. Este archivo digital que tenemos está en una librería robotizada. el formato es broadcast, es MXF en alta calidad. A partir de ahí aplicamos procesos de trascodificación para los clientes, de forma que les damos el producto con los requisitos que ellos demandan para nuestras propias plataformas en alta calidad, en baja calidad. Es decir, almacenamos un formato de preservación broadcast y a partir de ahí trascodificamos. Y ahora mismo estamos en el ETO 7, cada vez que saltamos una generación del ETO, multiplicamos nuestra capacidad de almacenamiento. Y todo esto está respaldado con otra librería que está en Barcelona, es decir, están físicamente separadas y cuando una falla, que no suele fallar, entra en juego la otra. Pero yo no creo en preservar todo. Bueno, creo que tendremos que tomar decisiones y tendremos que documentar las decisiones que tomamos. Y esa será la única manera de que la historia a lo mejor sea benévola. con nosotros y con nosotras Virginia, muchas gracias por la presentación algo que recién explicabas en cuanto a las tecnologías que están aplicando me interesaría, son dos preguntas de alguna manera, es de algún modo qué servicio están adaptando para la radio pública y cómo de alguna manera lo insertan en los modelos productivos visualizar un poquito más ese aspecto porque obviamente lo tuviste que mencionar muy dentro de un contexto más amplio de detalles, pero ahí anclar un poquito. ¿Y en qué medida los medios públicos podemos monetizar dentro de determinados tipos de preconceptos de que lo público tiene que estar accesible y abierto, que también estamos de acuerdo y sostenemos esa premisa, pero cómo también financiamos cuando no tenemos presupuesto? Entonces es otra pregunta existencial. No con el ánimo que puedas resolverlo tú ahora en este momento, pero sí al menos de alguna manera dentro de este debate siempre está un mecanismo administrativo administrativo o algo que es como una herejía vender. Entonces, sí, nosotros clasificamos bien los nichos y que, bueno, ahí podríamos quizá. Pero bueno, es parte de un debate. Gracias. Bueno, en relación a la primera pregunta, nosotros hemos integrado, nosotros tenemos un sistema de gestión de archivo que es un desarrollo propio, se llama ARCA y es la herramienta con la que trabajan nuestros equipos. A través de, o sea, lo que hemos hecho ha sido integrar esta herramienta con una solución que está en la nube, que es esta que veíamos en los vídeos, de tal manera que la persona que tiene que trabajar con analizar, catalogar un contenido de radio o de televisión, selecciona ese contenido desde su herramienta de trabajo y digamos que lo envía a este proveedor de inteligencia artificial. ¿Cómo lo envía? En el caso de la televisión son formatos en baja calidad, no movemos ficheros en alta calidad y en el caso de la radio la verdad es que los ficheros de audio, incluso los no comprimidos, pesan muy poco. Se envía a una carpeta, a una FTP donde el proveedor cada hora mira qué contenidos hay y se los lleva para aplicar, analizarlos con inteligencia artificial. Una vez que ha hecho el análisis, que el documentalista o la documentalista ha decidido cuál es, si va a ser en el caso de televisión solo audio o va a incluir la imagen o en el caso de radio también una serie de criterios. Cuando este análisis está hecho, la persona que ha lanzado el proceso entra en esta plataforma, lo que veíamos son plataformas de validación y control de calidad que están fuera del ecosistema RTVE, Revisa los metadatos, decide si el análisis es bueno, hace las correcciones que considere que sean relevantes para la recuperación y le da al botón de enviar a ARCA. Es decir, los metadatos se integran en nuestro sistema de gestión documental y hacen que sean accesibles. Es decir, es un círculo que se cierra. Esto respecto a cómo lo hemos integrado y esto no es baladí desde luego porque tienes que conectar como decía este ecosistema tan protegido con una solución en la nube y además tienes que indexar todos esos metadatos con lo cual tienes que evaluar cómo tu modelo de metadatos permite la incorporación de esos metadatos y cómo se indexan, qué índices creas. Todo esto que son cuestiones que parecen fáciles, pero que no, que obligan a una cierta reflexión. ¿Cómo se visualizan? ¿Cómo le dices al usuario que esos metadatos se han generado de manera automática y que tienen errores? Eso respecto a la primera pregunta. Y respecto a la segunda pregunta, lo público y monetizar lo público. Vale, ya nos vamos, tenemos que acabar. ¿Puedo responder? ¿No? Ah, que no se me oye. ¿No? ¿Que tenemos que cortar? Que alguien me diga algo. ¿A que cuatro minutos? Ah, voy a acabar antes de cuatro minutos. La respuesta, no, la respuesta es fácil. Una producción de archivo de Netflix que utiliza imágenes de una televisión pública. ¿No tenemos que cobrar a Netflix? ¿Por qué somos públicos? Me han sobrado tres minutos. Pues démosles un aplauso por favor, un aplauso grande a la doctora Virginia Bazangil y por supuesto a la doctora. Muchas gracias. Gracias. Thank you. Gobierno de México 't
SISTEMA
ATSC
DOCUMENTO_DIGITALIZADO
Sí
FECHA_AUTORIZACION
09/10/2025
FECHA_INGRESO_ENTREGA
28/10/2025
FECHA_PUBLICACION
20/05/2026
INGESTO
Jorge Vallejo Gutierrez
BARRA
Divulgación
TEMPORADA
1
TEMA_CONTENIDO
Bienal Internacional de Radios
FECHA_GRABACION
09/10/2025
LOCACION
CLASIFICACION
A
IDIOMA_ORIGINAL
Español
REALIZACION
Carlos Barrón López | Moisés Maximino Buenrostro Luna
PRODUCCION
Elvira Sánchez Salgado | María Enriqueta Godoy Mendoza
LIGA_COLECCION_INTERFAZ
https://interfaz.cenart.gob.mx/video/xv-bienal-internacional-de-radio/
LIGA_VIDEO_YOUTUBE
LIGA_PLAYLIST_YOUTUBE
https://www.youtube.com/playlist?list=PLCkToksdTuAnZPvEz7tWIoO29TWzvPP5j

